Jusqu'où automatiser une chaîne de développement avec des agents IA ?
Usine IA, mon projet agentique en cours, est le condensé de toutes mes chaînes précédentes : une petite usine logicielle autonome autour de find.bzh, où chaque étape doit prouver son travail à la suivante, et où l'IA doit aussi savoir dire non.

Ce projet s'appelle Usine IA, et il est en cours. C'est celui sur lequel je travaille en ce moment, et c'est aussi le condensé de tout ce que j'ai appris avec mes chaînes agentiques précédentes : l'Usine première version et ses portes de validation, DeepAgent et ses contrôles qualité, l'assistant qui apprend tout seul, puis la première chaîne de find.bzh. Tout ce qui a marché dans ces projets se retrouve ici, en plus solide. Tout ce qui a cassé aussi, en leçon.
Depuis quelques mois, je travaille sur une idée qui me fascine : jusqu'où peut-on réellement automatiser une chaîne de développement logiciel avec des agents IA, sans sacrifier la qualité, la sécurité et le contrôle humain ?
Pas simplement demander à une IA de générer quelques lignes de code.
Pas simplement ajouter un chatbot dans Jira ou Linear.
Mon objectif est beaucoup plus ambitieux : essayer de construire une véritable chaîne agentique de développement, capable de prendre un besoin exprimé en langage naturel, de le transformer en travail technique, de développer, tester, challenger le résultat, préparer un candidat Git, contrôler sa qualité et l'amener jusqu'aux portes de la mise en production.
Avec une obsession : l'humain ne doit plus servir de colle entre les outils.
Le problème que j'essaie de résoudre
Aujourd'hui, même avec des outils d'IA extrêmement performants, le fonctionnement reste souvent assez artisanal.
On demande quelque chose à ChatGPT. On copie la réponse dans un ticket. On lance Claude Code. On récupère son compte rendu. On regarde les tests. On copie un SHA quelque part. On vérifie une pipeline. On retourne dans Slack. On décide s'il faut publier.
Puis on recommence.
Autrement dit, les outils sont intelligents individuellement, mais l'orchestration reste humaine. Et c'est précisément cette partie qui m'intéresse.
Mon objectif avec Find.bzh, mon projet personnel, est donc de construire progressivement quelque chose qui ressemble davantage à une petite usine logicielle autonome.
Le workflow cible ressemble à ceci :
Besoin humain → ChatGPT → Linear → Claude Code → Git → DEV → QA → contrôles → publication
Chaque composant possède un rôle précis.
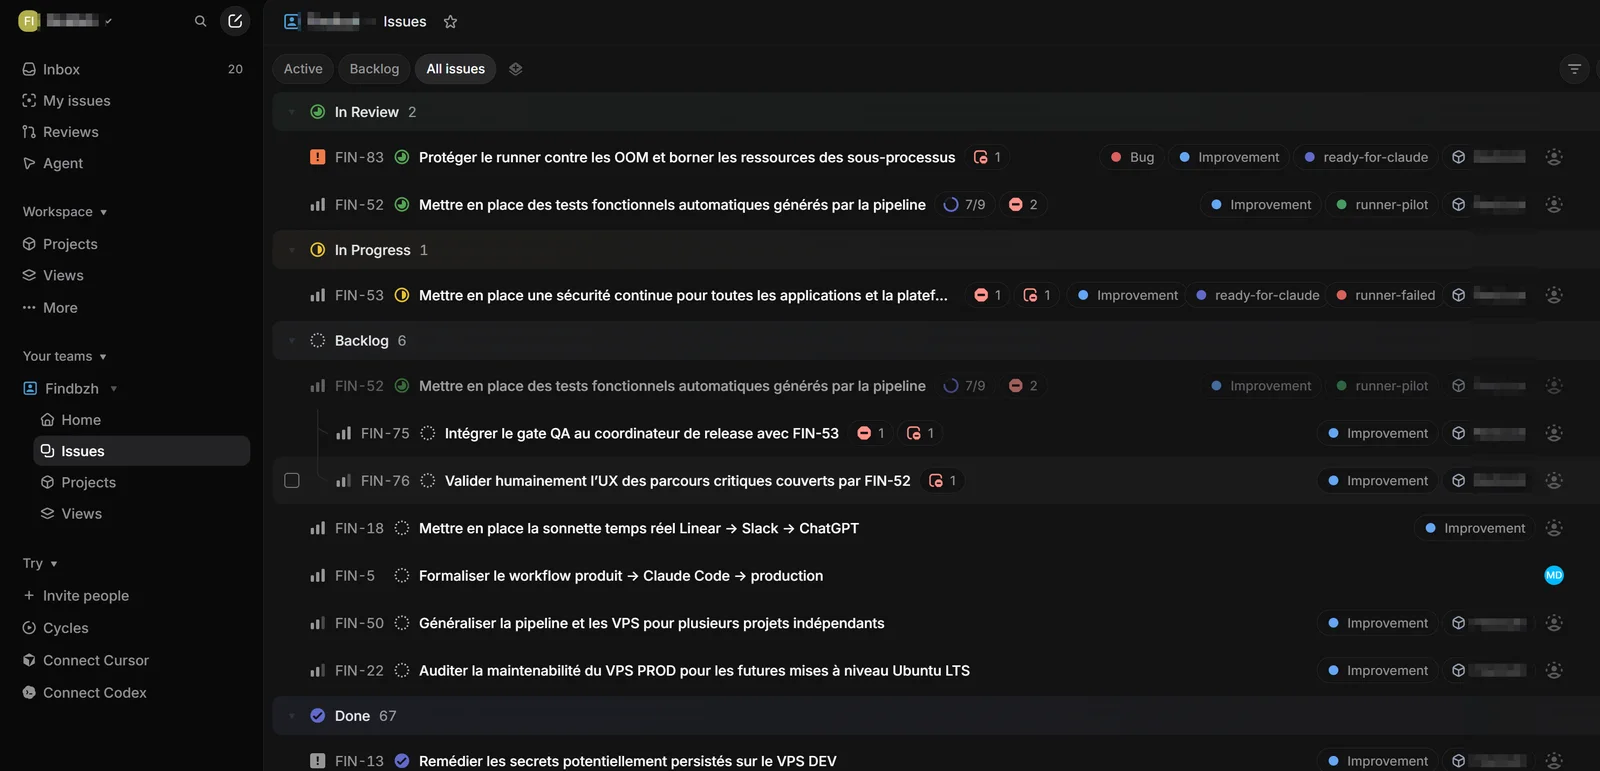
- Linear est la source de vérité opérationnelle.
- ChatGPT joue le rôle de pilote, de contrôleur et de reviewer : il transforme le besoin en objectifs exploitables, suit l'avancement, challenge les conclusions techniques et décide de la prochaine étape.
- Claude Code est l'ingénieur exécutant : il explore le dépôt, développe, crée les tests, exécute les contrôles et prépare les candidats Git.
- Des services indépendants prennent ensuite le relais pour la QA, la publication et, progressivement, la sécurité.
Le plus important : l'IA doit aussi savoir dire « non »
C'est probablement le point qui m'intéresse le plus dans cette expérimentation.
Je ne cherche surtout pas à construire un système où : « Claude a fini, donc on déploie. »
Au contraire. Je veux construire un système où chaque étape doit apporter une preuve à la suivante.
Un agent peut affirmer que son travail est terminé. Cela ne suffit pas. Il doit produire un commit précis. Ce commit doit être testé. Le DEV doit exécuter exactement ce SHA. La QA doit être rattachée exactement au même SHA. Le résultat doit être frais et vérifiable.
Si la QA est absente, périmée ou ambiguë, la publication est bloquée. Si un test est instable, même sans véritable échec fonctionnel, le système refuse aujourd'hui la publication.
Je trouve ce principe extrêmement intéressant : le système n'est pas conçu pour réussir à tout prix. Il est conçu pour échouer proprement lorsqu'il n'a pas suffisamment de preuves.
Git devient une transaction
J'ai également voulu traiter Git autrement qu'un simple git push.
Chaque mission travaille dans un environnement isolé. Elle part d'une base distante connue. Elle produit un candidat identifié par son SHA. Avant publication, la branche distante est relue. Si elle a avancé entre-temps, les hypothèses de départ doivent être revalidées. La publication n'est autorisée que lorsqu'un fast-forward propre est possible.
Autrement dit : le code testé doit être exactement le code publié.
Cela peut sembler évident. Dans une chaîne composée d'agents asynchrones, de runners, de QA et de services indépendants, ça ne l'est absolument pas.
Et les bugs deviennent des leçons d'architecture
C'est aussi là que le projet devient réellement intéressant. Dernier exemple en date.
J'ai lancé la construction de la couche de sécurité continue du système. Pendant son analyse, un sous-processus Python lancé par l'agent s'est mis à consommer plus de 6 Go de RAM. Le noyau Linux a fini par déclencher son OOM killer. Le runner a disparu.
Puis, quatre-vingt-dix secondes plus tard, l'automatisation a considéré l'exécution comme simplement « interrompue »… et a relancé exactement la même chose. Deuxième OOM.
À ce moment-là, le mauvais réflexe aurait été d'ajouter de la RAM et de relancer. Nous avons fait l'inverse : l'incident a été transformé en amélioration structurelle de la plateforme.
- Le runner possède maintenant un véritable budget mémoire géré au niveau des cgroups Linux.
- Il commence à subir une pression mémoire avant d'atteindre la limite critique, et il possède un plafond dur : il ne peut plus consommer toute la RAM du VPS.
- Et surtout, un OOM n'est plus traité comme une interruption générique : il devient un événement spécifique. Le système conserve la cause, la rattache à la mission et interdit automatiquement le retry aveugle.
C'est exactement le type de comportement que je recherche. Une chaîne agentique intéressante n'est pas une chaîne qui ne rencontre jamais de problème. C'est une chaîne qui apprend de ses modes de défaillance et devient progressivement plus difficile à casser.
L'objectif n'est pas de supprimer l'humain
Il y a également un malentendu fréquent autour de ce type d'automatisation. Je ne cherche pas à supprimer toutes les validations humaines. Je cherche à supprimer les validations humaines inutiles.
Pourquoi demander à quelqu'un d'écrire « GO » si :
- la QA est parfaitement verte ;
- le SHA est vérifié ;
- Git est à jour ;
- le fast-forward est valide ;
- il n'y a aucune migration ;
- aucune donnée n'est détruite ;
- aucune décision produit n'est nécessaire ;
- aucune opération sensible de production n'est impliquée ?
À l'inverse, une modification DNS, une migration destructive, un changement de secret, une décision produit importante ou un déploiement risqué doivent rester des décisions humaines.
La frontière qui m'intéresse est donc celle-ci : automatiser la routine, escalader l'exception.
L'humain ne devrait pas passer son temps à valider ce que la machine est parfaitement capable de prouver. Son temps devrait être réservé aux situations où il existe réellement une ambiguïté, un risque ou un choix.
Et surtout : éviter l'illusion de l'autonomie
C'est probablement l'une des leçons les plus importantes de cette expérimentation. Une chaîne peut donner une impression d'autonomie tout en restant dépendante d'un humain à un endroit très précis.
Par exemple, mon système sait déjà envoyer immédiatement une alerte Slack lorsqu'un nouveau gate apparaît. Mais aujourd'hui, cette alerte Slack ne « réveille » pas automatiquement cette conversation ChatGPT. Le système sait notifier l'humain. ChatGPT sait lire Slack lorsqu'il est sollicité. Mais la frontière Slack → ChatGPT n'est pas encore totalement événementielle.
Donc je refuse de dire que la chaîne est aujourd'hui autonome de bout en bout. Cette nuance peut paraître petite. Architecturalement, elle est énorme. Une chaîne n'est autonome que lorsque toutes ses frontières le sont réellement.
La prochaine étape : la sécurité comme agent de contrôle permanent
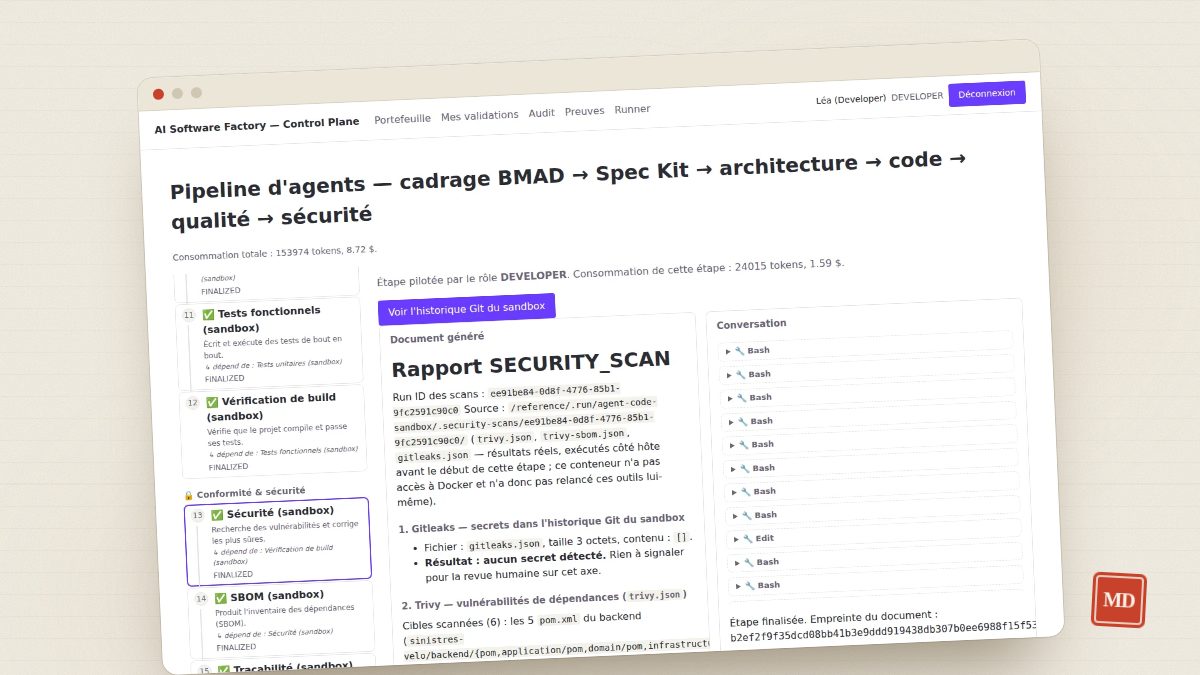
L'étape sur laquelle je travaille maintenant consiste à intégrer la sécurité dans cette même logique. Pas sous la forme d'un scan lancé de temps en temps, mais comme une boucle continue et multi-projets : analyse de dépendances, vulnérabilités, secrets, configuration des conteneurs, exposition réseau, TLS, permissions, dérive d'infrastructure, sauvegardes, configuration du runner lui-même…
Et à terme, le coordinateur de publication ne devra plus seulement demander « La QA est-elle verte ? » mais « La QA est-elle verte ET la posture de sécurité de ce SHA est-elle acceptable ? »
Même logique. Même rattachement au commit. Même refus en cas de preuve manquante.
Ce que cette expérience change dans ma vision de l'IA
Plus j'avance dans ce projet, moins je pense que le véritable bouleversement de l'IA dans le développement logiciel sera simplement « les développeurs coderont plus vite ».
Je pense que le changement beaucoup plus profond sera l'apparition de systèmes capables de prendre en charge des boucles opérationnelles entières : comprendre, planifier, exécuter, tester, observer, critiquer leur propre résultat, échouer proprement, demander de l'aide lorsqu'une décision sort de leur mandat, puis reprendre le travail.
Le code n'est alors plus qu'une étape parmi d'autres. Et c'est précisément ce que j'essaie d'explorer avec cette expérience.
Je ne construis pas simplement un agent qui développe Find.bzh. J'essaie de construire autour de lui le système qui lui permet de travailler de manière fiable.
Et finalement, c'est peut-être là que se situe le vrai sujet des agents IA en entreprise : pas remplacer un outil par une IA, mais repenser complètement la manière dont le travail circule entre les humains, les logiciels et les machines.