Usine IA : les véritables défis du développement autonome
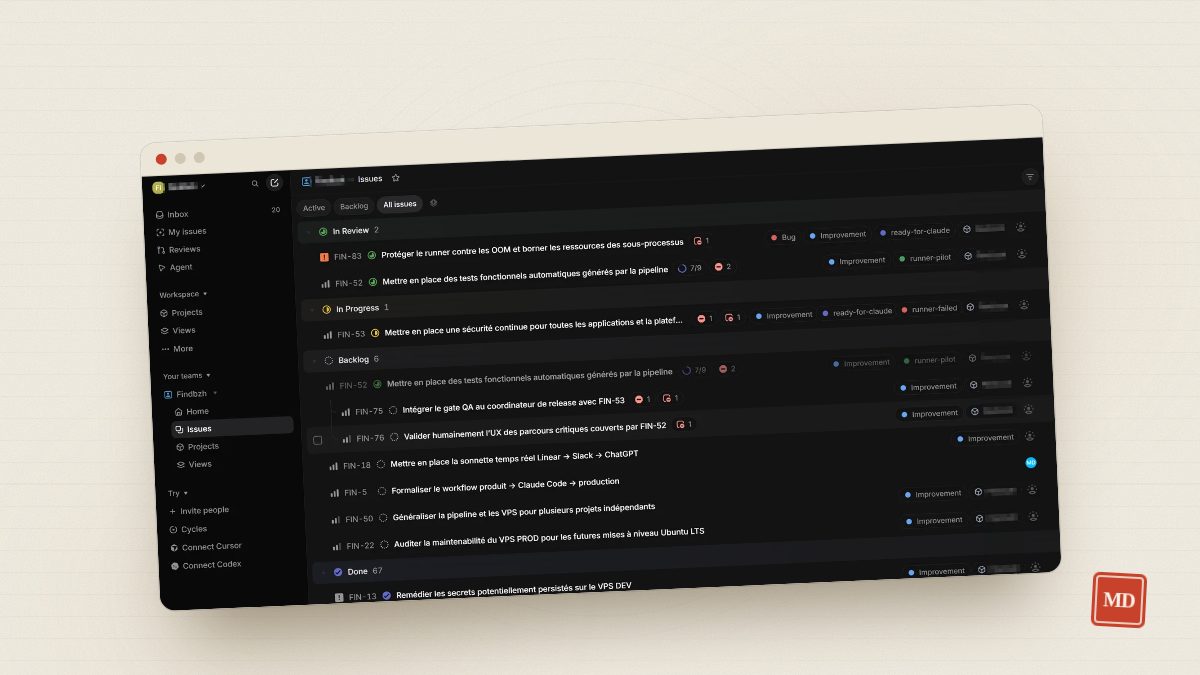
Retour d'expérience sur la conception d'une chaîne de développement logiciel orchestrée par l'intelligence artificielle : après plus de 80 tickets et plusieurs incidents, cinq enseignements.

L'IA sait désormais générer du code, corriger des anomalies, exécuter des tests et interagir avec des environnements techniques complexes. Pourtant, la capacité à développer ne garantit pas celle à produire un logiciel de manière autonome et fiable.
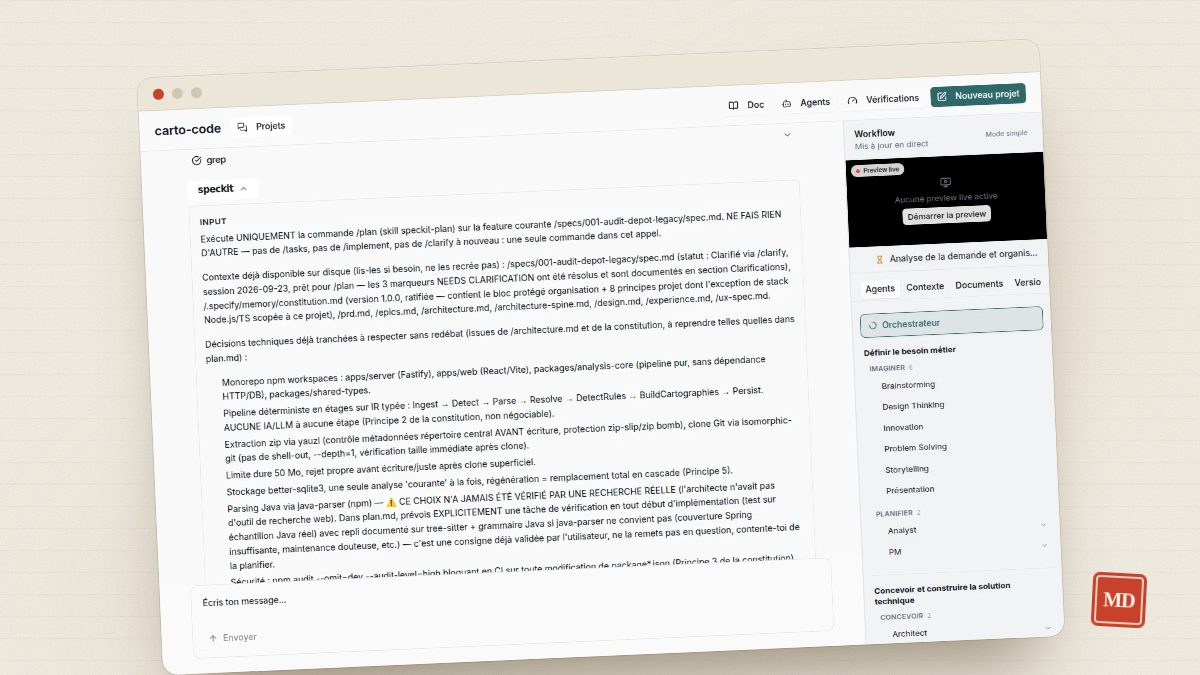
C'est le principal enseignement de mon projet Usine IA, une chaîne de développement associant ChatGPT, Claude Code, Linear, GitHub et plusieurs mécanismes de contrôle indépendants. Je présente Usine IA en détail dans « Jusqu'où automatiser une chaîne de développement avec des agents IA ? » ; cet article en tire le bilan.
Après plus de 80 tickets et plusieurs incidents techniques, cinq enseignements se dégagent.
1. L'orchestration devient plus complexe que le développement
Le principal défi ne réside plus uniquement dans la génération de code, mais dans la coordination des agents, la gestion des dépendances, le contrôle des permissions et la validation des résultats.
Chaque composant doit disposer d'une responsabilité clairement définie. Un agent chargé de développer ne doit pas pouvoir valider et publier seul son propre travail.
2. L'autonomie exige des mécanismes de contrôle indépendants
Une chaîne autonome doit pouvoir interrompre une opération lorsque les garanties attendues ne sont pas réunies.
Dans Usine IA, une publication a notamment été bloquée en l'absence de résultats de tests associés à la bonne version du code. Un autre contrôle a refusé une publication après 30 tests réussis sur 31, le dernier étant instable.
L'absence de preuve de réussite ne doit jamais être assimilée à une réussite.
3. Les principales défaillances apparaissent aux interfaces
Les incidents les plus instructifs ont concerné les interactions entre composants : résultats de tests associés au mauvais ticket, transmission incorrecte de secrets, incohérences entre artefacts ou notifications prématurées.
Ces problèmes démontrent que la fiabilité d'un système multi-agents dépend autant de ses protocoles d'échange que de la qualité de chaque agent.
4. Les agents nécessitent un environnement d'exécution maîtrisé
Une opération automatisée a provoqué deux épuisements successifs de la mémoire du serveur. Un autre incident a révélé qu'un agent pouvait terminer son exécution sans produire le résultat structuré attendu.
Ces événements ont conduit à renforcer les limites de ressources, les règles de reprise et les contrats de sortie.
Un agent autonome doit pouvoir échouer sans compromettre le reste du système.
5. La traçabilité devient une condition de l'autonomie
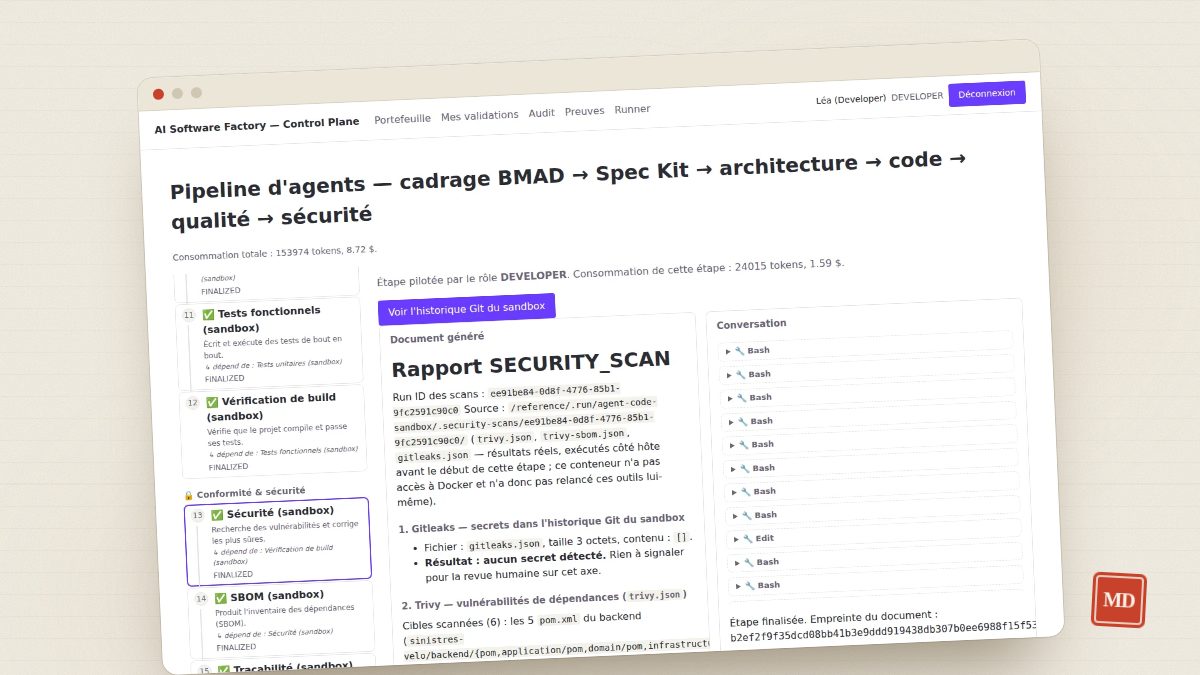
Lorsque plusieurs agents interviennent successivement, il devient indispensable de garantir que le code testé correspond exactement au code publié.
L'identification des modifications par leur empreinte Git, la conservation des preuves de tests et la séparation des responsabilités permettent de sécuriser cette continuité.
La traçabilité n'est plus seulement un outil d'audit : elle devient un mécanisme opérationnel de confiance.
Conclusion
Cette expérience met en évidence une évolution importante : le véritable enjeu du développement assisté par IA se déplace progressivement de la génération de code vers l'ingénierie des systèmes autonomes.
Les modèles progressent rapidement, mais leur intégration dans des processus fiables nécessite une architecture rigoureuse : isolation, observabilité, contrôle des privilèges, validation indépendante et gestion explicite des échecs.
L'objectif n'est pas de supprimer toute intervention humaine, mais de concentrer celle-ci sur les décisions qui nécessitent réellement du jugement.
La prochaine étape ne consiste donc pas seulement à rendre les agents plus performants, mais à rendre leur autonomie vérifiable, maîtrisable et reproductible.
Retour d'expérience — Usine IA, octobre 2026.